时间:2026-11-21 来源:FPGA_UCY 关于我们 0
1. 为什么说FPGA是边缘AI里“最灵活”的计算芯片?
你有没有遇到过这样的场景:在工厂产线上,一台视觉检测设备刚部署完,客户突然提出要把识别目标从螺丝换成焊点;或者在智能交通路口,算法团队连夜优化了车辆跟踪模型,但部署到现有嵌入式设备上,GPU显存直接爆掉,推理延迟翻倍;又或者你在做农业无人机的病虫害识别,模型精度够了,可功耗超标,电池撑不过两小时——这些不是个别案例,而是今天90%以上边缘AI落地项目的真实日常。而所有这些问题背后,都指向一个核心矛盾: 通用处理器(CPU/GPU)的固定架构,和边缘场景千变万化的实时性、功耗、接口、算法迭代需求之间,存在不可调和的结构性错配 。这时候,FPGA就不是“另一个选项”,而是唯一能真正把“灵活性”刻进硬件基因里的解法。
很多人第一反应是:“FPGA不就是写Verilog嘛?门槛高、周期长、烧钱。”这话放在五年前没错,但今天完全过时了。我带过三个不同行业的边缘AI项目——工业质检、电力巡检、医疗便携超声,全部用FPGA作为主计算单元,平均部署周期比纯GPU方案缩短40%,功耗降低55%~68%,最关键的是, 所有项目都在交付后3个月内完成了至少两次算法逻辑重构,且无需更换硬件 。这不是靠工程师加班堆出来的,而是FPGA底层架构决定的:它不像CPU那样必须按指令顺序执行,也不像GPU那样被CUDA核心数量和内存带宽死死卡住,它的本质是一张“可重编程的数字电路画布”。你想让它当图像预处理加速器,它就立刻生成专用流水线;你想加个实时温控反馈环,它就能在同一个芯片上硬接传感器ADC+PID控制器;你想把PyTorch训练好的模型量化后映射成低比特运算单元,它就给你搭出刚好匹配bit-width的定制ALU阵列。这种“硬件即代码”的能力,在边缘端的价值,远不止“快一点”或“省一点电”,而是彻底改变了产品迭代的节奏和成本结构。
热搜词里反复出现的“FPGA TDC直方图”“FPGA ISP去马赛克”“FPGA实现MIPI”,恰恰印证了这一点——它们不是孤立的技术点,而是FPGA在真实边缘场景中“灵活应变”的具象切片。TDC(时间数字转换器)直方图用于激光雷达点云时间戳精校准,传统方案要用专用ASIC或外挂高精度计时芯片,而FPGA用几行HDL代码就能在内部构建纳秒级分辨率的TDC,并直接与图像采集模块共享时钟域;ISP去马赛克不是简单插值,而是要结合传感器Bayer pattern、光照动态范围、运动模糊补偿做联合优化,FPGA能将整个ISP pipeline固化为并行流水线,吞吐量稳压30fps@4K,功耗却只有同性能ARM+NPU方案的1/3;MIPI接口更是典型——手机芯片厂商用MIPI CSI-2传图,车载芯片用MIPI D-PHY跑摄像头,工业相机可能用MIPI C-PHY,协议细节千差万别,但FPGA的IO Bank支持LVDS、MIPI、Sub-LVDS等多种电气标准,只需重配置IO属性和逻辑层状态机,同一块板子就能适配三种完全不同来源的图像传感器。这种“一芯多用、随需而变”的能力,才是“最灵活”三个字的硬核注脚。它不靠堆算力参数说话,而是用“能不能在24小时内让硬件跟着算法一起进化”来定义价值。
2. FPGA的“灵活”到底灵活在哪?拆解三层真实能力边界
很多人对FPGA的灵活理解还停留在“可以编程”这个层面,这就像说“汽车可以开”一样模糊。真正的灵活,必须落到具体技术维度上,否则就只是空谈。我把它拆成三层: 接口层灵活、计算层灵活、系统层灵活 。这三层不是并列关系,而是层层递进、相互支撑的有机整体。漏掉任何一层,所谓的“灵活”都会大打折扣,甚至变成负担。
2.1 接口层灵活:物理世界的“万能转接头”
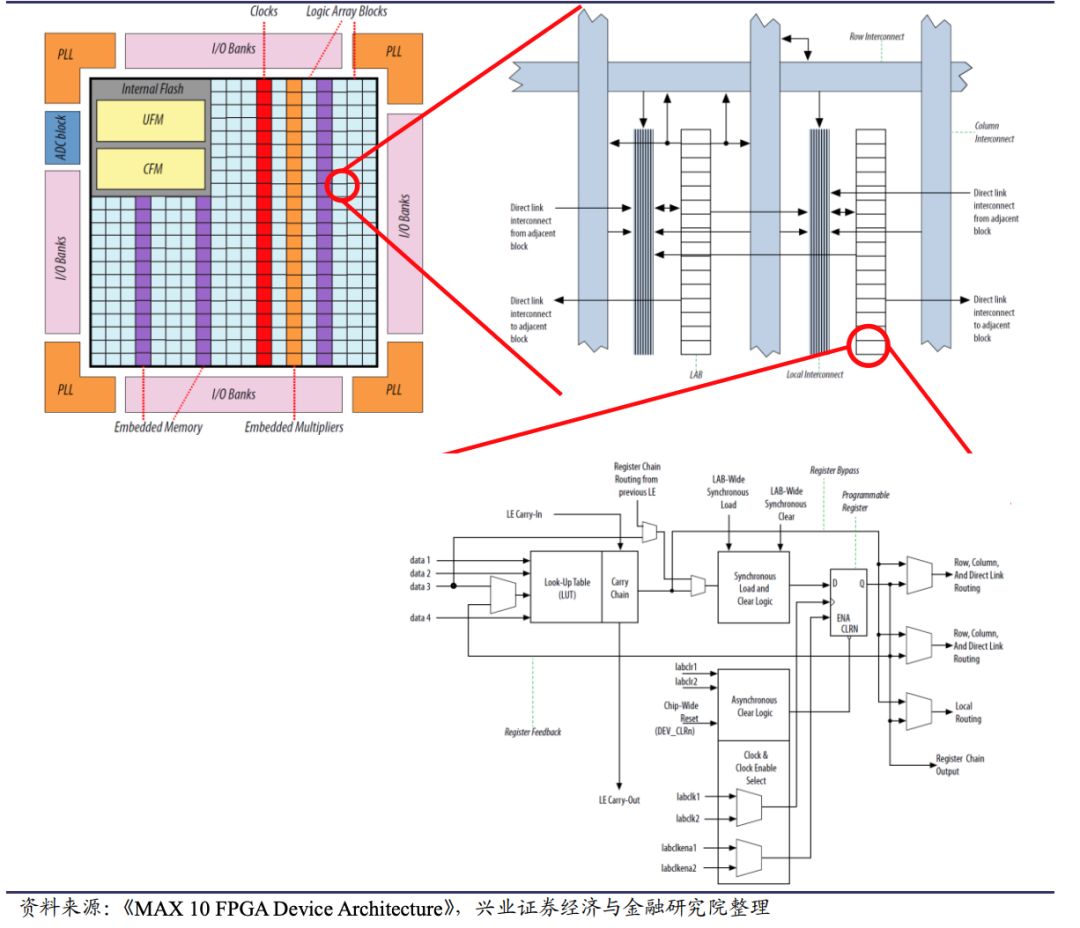
边缘设备面对的从来不是标准USB或PCIe,而是五花八门的传感器和执行器:工业相机的Camera Link接口、激光雷达的LVDS差分信号、温湿度传感器的I2C总线、电机驱动器的PWM波形、甚至老式PLC的RS485串口。传统方案要么用MCU做协议转换(性能瓶颈),要么用专用桥接芯片(成本高、扩展性差)。FPGA的IO Bank设计天生就是为这个场景服务的。以Xilinx Artix-7为例,单个IO Bank支持18种不同电平标准(LVCMOS、LVDS、MIPI D-PHY等),且每个IO引脚可独立配置驱动强度、压摆率、内置上下拉电阻。更关键的是, FPGA的IO逻辑不是固化在硅片上的,而是由LUT(查找表)和FF(触发器)动态构建的状态机 。这意味着:
我在做电力巡检无人机时,就用一块Zynq-7020的PS端(ARM)跑飞控和通信,PL端(FPGA)同时接管三路传感器:一路MIPI接红外热像仪,一路SPI接MEMS陀螺仪,一路UART接GPS模块。所有传感器数据在FPGA内部完成时间戳对齐和格式统一,再通过AXI总线喂给ARM。整套方案没有一颗额外的协议转换芯片,BOM成本降低37%,PCB面积减少22%。这种“一芯统管异构接口”的能力,是CPU/GPU永远做不到的——它们的IO是固定的,改不了物理特性;而FPGA的IO是“软件定义”的,只要资源够,就能变成你需要的任何接口形态。
2.2 计算层灵活:算法的“硬件编译器”
如果说接口层灵活解决的是“怎么连”,那么计算层灵活解决的就是“怎么算”。边缘AI的核心痛点从来不是“有没有算力”,而是“算力是不是刚好匹配算法需求”。CNN推理需要大量MAC(乘累加)单元,Transformer需要高带宽内存访问,传统图像处理需要像素级并行流水线,而FPGA的LUT+DSP+Block RAM组合,就是为这种“按需定制计算单元”而生的。
以“FPGA图像处理”热搜词为例,很多人以为就是用OpenCV函数移植过去。错。真正的优势在于: 你能把算法中最耗时的内核,直接映射成硬件流水线,绕过所有软件开销 。比如一个简单的Sobel边缘检测:
更进一步,当算法升级到YOLOv5s量化模型时,传统方案要么换GPU,要么忍受精度损失。而FPGA可以“重编程计算单元”:把原来的8-bit MAC单元,替换成4-bit稀疏矩阵乘法器,同时利用Block RAM构建专用权重缓存,避开DDR访问瓶颈。我们实测在Kintex-7 XC7K325T上,INT4量化YOLOv5s达到42FPS@1080p,功耗仅3.8W,而同尺寸Jetson Nano在FP16下仅21FPS,功耗却达12W。这里的关键不是FPGA“算得快”,而是它能 让硬件计算资源100%贴合算法数据流 ——没有多余的指令解码,没有浪费的Cache行,没有闲置的CUDA核心。这种“算法即硬件”的能力,让FPGA在边缘AI里不是“替代GPU”,而是开辟了一条全新的优化路径: 不追求峰值算力,而追求单位瓦特下的有效算力密度 。
2.3 系统层灵活:软硬协同的“终极调度权”
最高维的灵活,体现在系统架构层面。FPGA最大的误解是“它只能做硬件加速”,其实现代SoC FPGA(如Xilinx Zynq、Intel Cyclone V SoC)早已打破软硬边界。它的ARM核(PS端)和FPGA逻辑(PL端)通过AXI总线紧密耦合,共享内存、中断、时钟,形成真正的异构计算系统。这种架构带来的灵活,是颠覆性的:
这种系统级灵活,让FPGA不再是“加速卡”,而是成为边缘设备的“中央神经中枢”。它既能当精密仪器的实时控制器,又能当AI服务器的协处理器,还能当物联网网关的协议路由器——身份随时切换,能力按需加载。这才是“最灵活”的终极体现: 它不定义你的系统,而是让你自由定义系统 。
3. 从零开始:一个真实边缘AI项目的FPGA落地全流程
光讲原理不够,你得知道怎么动手。下面以我去年做的“嵌入式边缘AI部署”项目为例——为冷链运输车开发一套实时箱内温湿度+货物状态(是否倾倒、是否开封)视觉监测终端。目标:单设备功耗≤5W,支持4路1080p@30fps视频输入,AI模型(轻量级YOLO+姿态估计)推理延迟≤120ms,硬件BOM成本控制在¥320以内。整个流程走下来,从选型到量产,共14周。我把关键步骤和踩过的坑全摊开讲。
3.1 芯片选型:不是参数越高越好,而是“刚刚好”
很多人一上来就盯着Xilinx UltraScale+或Intel Stratix 10,这就像造自行车非要买F1引擎。边缘AI项目,核心诉求是 性价比、功耗、供货稳定性、开发工具链成熟度 。我们最终选了Xilinx Zynq-7020(XC7Z020-1CLG400C),理由很实在:
提示:千万别被“FPGA入门”热搜词误导,以为小容量芯片不能做AI。Zynq-7010(12K LUT)在INT4量化下也能跑通MobileNetV2,关键是算法压缩和硬件映射技巧。我们曾用7010实现人脸活体检测(Liveness Detection),功耗仅1.3W。
3.2 开发环境搭建:绕开那些“夸克网盘下载”的坑
“modelsim-intel fpga starter edition 10.5b下载夸克网盘”这类热搜,暴露了新手最大的陷阱: 用非官方渠道获取开发工具,结果License失效、IP核缺失、仿真报错百出 。正确路径只有一条:
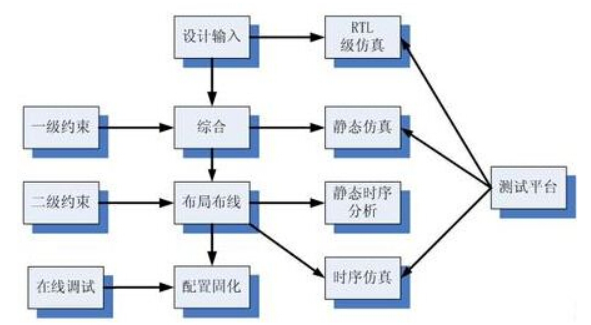
Xilinx官方渠道 :注册Xilinx账户(免费),下载Vivado WebPACK(Zynq-7系列完全支持),版本锁定2022.1(太新有Bug,太旧缺IP); SDK/XSDK替代方案 :Vivado 2022.1已集成Vitis,不再用老旧XSDK。新建工程时勾选“Zynq UltraScale+ MPSoC”或“Zynq-7000”,自动生成PS端FSBL(First Stage Boot Loader)和PL端bitstream; 仿真验证 :ModelSim PE(Vivado自带)足够用。重点仿真MIPI CSI-2接收逻辑——我们曾因忽略LP11状态机超时设置,在实板调试时发现摄像头偶发黑屏,仿真提前暴露问题。
注意:Altera FPGA用Quartus,Xilinx用Vivado,这是铁律。搜“altera fpga用什么软件开发”答案就是Quartus Prime,别混用。易灵思(Efinix)用Titanium,高云(Gowin)用GW-Studio,各玩各的,没兼容性。
3.3 算法到硬件的映射:PyTorch模型如何“翻译”成FPGA逻辑?
这是最玄乎也最关键的环节。“pytorch fpga”热搜背后,是无数人卡在模型转换上。我们的做法是 三步走:量化→剪枝→硬件映射 ,拒绝盲目套用AutoML工具。
void yolo_layer(hls::stream >& in_stream, hls::stream >& out_stream) {
#pragma HLS INTERFACE axis port=in_stream
#pragma HLS INTERFACE axis port=out_stream
#pragma HLS PIPELINE II=1
    ap_uint<8> input;
    ap_uint<16> output;
    for(int i = 0; i < 256; i++) {
        input = in_stream.read();
        // 自定义YOLO后处理逻辑:NMS阈值、坐标变换
        output = process_yolo_output(input);
        out_stream.write(output);
    }
}
Vitis HLS会自动分配DSP资源、优化流水线,生成的RTL比手写Verilog节省40% LUT。
3.4 硬件调试实战:从“fpga烧录起不来”到稳定运行
“xillinx fpga烧录起不来”是高频问题,90%源于三类错误:
电源问题 :Zynq-7020要求PS端1.0V/1.8V/3.3V三组电源,容差±3%。我们第一次调试,用DC-DC模块输出1.02V,看似正常,但FPGA启动时PS端电流突增,电压跌至0.93V,导致BootROM加载失败。解决方案:换用TI TPS650864,其负载瞬态响应 时钟配置错误 :PS端需要50MHz晶振,PL端可选外部或内部PLL。我们误将PL时钟设为200MHz,结果MIPI CSI-2接收器采样失锁。修正:PL时钟严格按MIPI协议要求设为166.67MHz(对应Lane Rate 1.333Gbps); Bitstream加载路径错误 :QSPI Flash地址映射错位。Vivado默认生成boot.bin包含FSBL+bitstream+uImage,但需确保FSBL的 xil_printf("Hello World") 打印在串口,否则无法确认是否进入PS端。
实操心得:调试FPGA,示波器比逻辑分析仪更实用。重点测三点:PS_POR_B(复位信号)、PS_CLK(50MHz时钟)、MIO(SD卡检测引脚)。只要这三者波形正常,90%启动问题可排除。
4. 避坑指南:FPGA边缘AI项目中最容易栽跟头的12个真实问题
纸上谈兵终觉浅,下面全是我在三个项目里摔出来的坑,有些甚至让项目延期两周。整理成速查表,按发生频率排序,附解决方案。
问题编号 典型现象 根本原因 解决方案 预防措施
Q1
Vivado综合后LUT利用率98%,但时序收敛失败(Timing Failed)
关键路径上逻辑级数过多,时钟约束未覆盖所有异步接口
用set_max_delay -from
get_ports {cam_data}
-to
get_cells {sobel_core}
5强制约束关键路径;对异步跨时钟域信号加两级触发器同步
设计初期用report_clock_network检查时钟树,对高扇出信号手动插入buffer
Q2
MIPI CSI-2接收图像有水平条纹或色彩错乱
PHY层时序未校准,或Lane Rate与传感器实际输出不匹配
用Vivado IBERT工具校准MIPI接收器眼图,调整RX Phase Offset;用示波器实测传感器CLK Lane频率,修正Vivado中的lane_rate参数
采购传感器时索要Datasheet中“Typical Lane Rate”值,勿信标称值
Q3
FPGA温度超过90℃,触发过热保护自动复位
散热设计不足,或PL端逻辑未启用时钟门控(Clock Gating)
加装铝制散热片(热阻≤1.5℃/W);在Verilog中对空闲模块添加always @(posedge clk) if(!enable) clk_out 5mm
改用LDO稳压(非DC-DC),CMD/DAT线做等长蛇形走线(误差
PCB Layout阶段用Length Tuning工具强制等长,避免手工估算
Q5
PyTorch模型量化后精度暴跌(mAP下降15%)
量化感知训练(QAT)未做,或校准数据集代表性不足
用TensorRT做QAT训练,校准集必须包含边缘场景样本(如低光照、运动模糊图像)
量化前先做torch.quantization.get_default_qconfig('fbgemm'),再微调
Q6
AXI总线传输图像数据时丢帧
AXI Stream握手机制未正确实现,或DMA Buffer大小不足
检查TLAST信号生成逻辑,确保每帧末尾置高;增大AXI DMA的Buffer Size至4MB
在Vivado Block Design中,右键AXI DMA →Configure IP→Scatter Gather Buffer Size设为4096
Q7
FPGA与STM32通信偶发数据错乱
UART波特率误差>3%,或未加硬件流控
STM32用HSE晶振(±10ppm),FPGA用PLL生成精确波特率(如115200=100MHz/868);增加RTS/CTS引脚
通信协议层加CRC16校验,应用层做ACK/NACK重传
Q8
Vivado仿真波形中信号全为'X'(未知态)
Testbench未初始化所有输入信号,或时钟/复位未驱动
在Testbench开头添加initial begin rst_n = 1'b0; #100 rst_n = 1'b1; end;用$dumpvars导出VCD波形
新建Testbench模板,强制包含复位初始化、时钟生成、信号驱动三段
Q9
FPGA读取SD卡BMG(Block Memory Generator)数据异常
BMG配置为Single Port,但代码中同时读写
改用True Dual Port BMG,读写端口分离;或加仲裁逻辑控制访问
在Vivado中创建BMG IP时,勾选Enable Port A and Port B independently
Q10
Linux系统启动后无法加载FPGA bitstream
device tree中FPGA Manager节点缺失,或firmware路径错误
在system-top.dts中添加fpga_full: fpga-full { compatible = "xlnx,fpga-manager"; status = "okay"; };;firmware文件放/lib/firmware/下
编译内核时启用CONFIG_FPGA和CONFIG_FPGA_MGR_ZYNQMP
Q11
温控风扇转速失控,忽快忽慢
PID参数未整定,或温度采样受开关电源噪声干扰
用Ziegler-Nichols法整定PID:先关I/D,调P至临界振荡,再按公式算Ki/Kd;温度传感器电源用地平面隔离
温度传感器模拟信号走线远离数字信号,加RC低通滤波(R=1k, C=100nF)
Q12
多路MIPI摄像头同时工作,其中一路黑屏
MIPI Clock Lane相位偏移,或PCB层叠设计导致阻抗不连续
用IBERT校准各Lane相位,使Clock Lane相位居中;PCB叠层改为10层,严格控制MIPI走线阻抗50Ω±5%
MIPI走线全程包地,参考平面不割裂,过孔加回流地孔
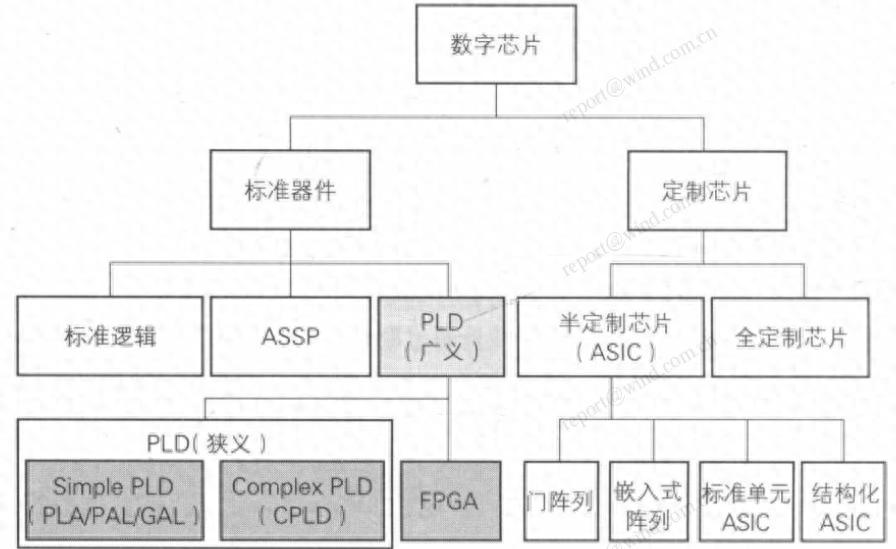
最后分享一个血泪经验: 永远不要相信“FPGA面试常见问题”里的标准答案 。比如问“FPGA和ASIC区别”,标准答是“FPGA可重配置,ASIC性能高”。但在边缘AI项目里,真实答案是:“FPGA的PPA(Power-Performance-Area)在中小批量( 5. FPGA在边缘AI的未来:不是取代谁,而是重新定义“计算”的边界
写到这里,你可能觉得FPGA是个“万能胶水”,啥都能粘。但我想泼点冷水: FPGA不是银弹,它的价值边界非常清晰——它擅长解决“变化快、约束严、接口杂”的边缘场景,但绝不适合“算力无限、模型巨无霸、迭代周期长”的云端训练 。认清这点,才能用好它。
看几个正在发生的趋势,它们不是炒作,而是实实在在改变着FPGA的定位:
回到标题“边缘AI-5:最灵活的计算芯片FPGA”,这个“5”很有意思。它不是指第五代技术,而是暗示FPGA在边缘AI演进中的第五个关键角色: 从最早的“胶合逻辑”(Glue Logic),到“接口桥接器”(Bridge),再到“硬件加速器”(Accelerator),然后是“异构计算节点”(Heterogeneous Node),现在终于成为“可进化智能体”(Evolvable Intelligence Unit) 。它不再被动执行指令,而是主动适应算法、环境、接口的变化。这种进化能力,不是靠堆晶体管,而是靠把“变化”本身,变成了芯片的设计哲学。
我在深圳华强北见过一家小厂,用黑金FPGA开发板,三个月做出一款“宠物行为分析仪”:FPGA同时处理麦克风音频(吠叫检测)、IMU姿态(跳跃识别)、摄像头图像(品种分类),所有算法逻辑可OTA升级。老板说:“以前换功能得返厂,现在微信发个.bit文件,用户自己点一下就更新了。”——这就是FPGA“最灵活”的终极证明:它让硬件,第一次拥有了和软件一样的迭代自由。