时间:2026-10-07 来源:FPGA_UCY 关于我们 0
FPGA 开发全流程:从 Verilog 到比特流上板
更新时间:2026-09-12。本文是 fpga/ 入门层第 02 篇,接 开发板与工具链。装好工具链之后,新手最需要的是一张「全局地图」:我写的这段 Verilog,到底经过哪些步骤才跑到芯片上?每一步在做什么、报什么错该回到哪?这一篇把整条链路讲透。具体到第一个能跑的工程,见 第一个工程:LED 与计数器。
本文要回答的问题 一、七个步骤全景
FPGA 开发和写软件最大的区别是:你不是在「写指令」,而是在「描述一个电路」,然后让工具把这个电路映射、摆放、连线到芯片的真实资源上。整条链路分七步:
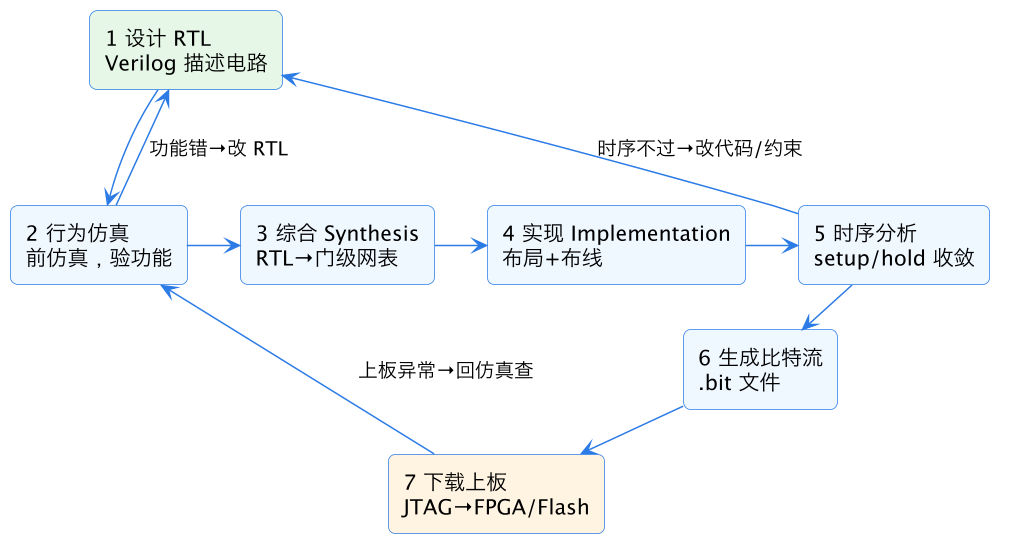
注意三条「回头路」:功能错回第 1 步改 RTL,时序不过回代码或约束,上板行为异常回仿真复现。越早发现问题代价越小——这就是为什么仿真放在综合前面。
二、逐步拆解
1. 设计(RTL 编写)。用 Verilog 描述你要的电路结构和行为。这一步心里要始终装着「我描述的是硬件」:每段 always 要么是一块组合逻辑、要么是一组触发器,不是顺序执行的程序。写法范式见 Verilog 设计基础。
2. 行为仿真(前仿真)。写一个 testbench(测试台)给设计喂激励、看波形,验证逻辑功能对不对。这一步不考虑门延迟,只验证「功能」。优点是快、能看任意内部信号;缺点是抓不到时序问题。新手最容易跳过仿真直接上板,结果 LED 不亮都不知道是逻辑错还是约束错——务必先仿真。
3. 综合(Synthesis)。综合工具把你的 Verilog「翻译」成由 FPGA 真实资源(LUT、触发器、BRAM、DSP)构成的门级网表。这一步会做优化(合并冗余逻辑、推断 RAM/DSP),并报告用了多少资源。综合后你能看到 schematic(电路原理图),如果和你想的不一样(比如意外综合出锁存器),说明代码有问题。
综合器内部做的事,入门阶段值得知道个大概,因为它解释了大量「我写的和综合出来的不一样」的现象:
一个反复强调的判断标准:综合后的 schematic 是你和「工具以为你想要的硬件」对账的唯一窗口。代码能仿真只代表行为对,schematic 才代表结构对。
4. 实现(Implementation)。这一步把门级网表落到具体芯片上,分两小步:
5. 时序分析(Timing)。工具根据你写的约束(时钟周期、输入输出延迟)计算每条路径能不能在时钟沿前稳定下来,给出建立时间(setup)/保持时间(hold) 是否满足的报告。这一步报红(timing violation)就说明电路在这个时钟下会出错,必须回去打流水线、改约束或降频。时序是 FPGA 最核心的难点,入门先建立「时序不过不能上板」的意识,进阶见 时序约束与收敛。
这里先建立整条 FPGA 学习中最重要的一条物理直觉——寄存器到寄存器路径的周期预算:
        发射沿                  捕获沿
 clk ─────┐                      ┌──────
 FF1 ──→ t_co ──→ [组合逻辑延迟 t_logic] ──→ FF2 的 D
            └──── 必须在一个周期 T 内,提前 t_setup 稳定 ────┘

 必须满足: T ≥ t_co + t_logic + t_setup − 时钟偏斜(skew)
t_co 是时钟沿到 FF1 输出更新的延迟,t_logic 是两级寄存器之间组合逻辑的延迟(LUT 级联、布线),t_setup 是 FF2 要求数据提前稳定的时间,时钟偏斜是时钟到达两个寄存器的时间差。如果 t_logic 太大(一条路径串了太多级 LUT/运算),周期 T 装不下,就是建立时间违例(setup violation / WNS,这条路径跑不到目标频率。典型修法就是在中间插一级寄存器把长组合逻辑切成两拍(流水线),或降低时钟频率。保持时间违例(hold / WHSSTA 入门 会完整展开,本篇先记住「时序不是软件里的运行快慢,而是物理上数据赶不赶得上时钟沿」。
6. 生成比特流(Bitstream)。布局布线完成且时序收敛后,工具把整个电路的配置信息(每个 LUT 的真值表、每条连线的开关、每个触发器的初值)打包成一个 .bit 二进制文件。这就是 FPGA 版的「可执行文件」。
7. 下载上板。通过 JTAG 接口把比特流传进 FPGA。两种目的地:
三、每一步看什么、错了回哪 步骤主要产物重点看什么出问题回哪
行为仿真
波形
逻辑功能、状态跳转
改 RTL
综合
网表、资源报告
资源用量、意外锁存器警告
改 RTL
布局布线
布局布线结果
布线拥塞、资源是否超限
改代码/换大芯片
时序分析
时序报告
setup/hold 是否 slack 为正
打拍/改约束/降频
下载上板
板上行为
实际功能、时钟是否正确
回仿真复现
一个实用习惯:每个警告都当回事。综合和布局布线阶段的 warning(比如「inferred latch」「signal has no load」「multi-driven net」)往往就是上板异常的伏笔,别等行为不对了再回头翻。
四、和软件开发的对比 维度软件开发FPGA 开发
产物
可执行指令流
电路配置(比特流)
执行方式
CPU 逐条取指令
电路并行同时工作
调试
断点、打印
仿真波形、片上逻辑分析仪(ILA)
「编译」
编译链接
综合+布局布线(慢得多)
正确性
功能对即可
功能对 且时序收敛
迭代速度
秒级
分钟到数十分钟
正因为 FPGA 迭代慢(综合布局布线一次几分钟到几十分钟),前仿真越充分越省时间——软件改一行秒重编,FPGA 改一行要重走整条链路,所以把问题挡在仿真阶段非常划算。片上抓信号的调试手段见 调试技巧 ILA/VIO。
五、一个工程里都有哪些文件
第一次打开 Vivado/Quartus 工程会被一堆文件绕晕,其实核心就几类,认住它们就不慌:
文件类型作用你要不要手写
RTL 设计源文件(.v/.sv)
你描述的电路
手写,核心
Testbench(_tb.v)
仿真激励,不可综合
手写
约束文件(.xdc/.sdc)
时钟周期 + 管脚绑定
手写,见约束入门
IP 核文件
PLL/FIFO 等生成的模块
工具配置生成
网表/布局布线中间产物
综合实现的中间结果
工具自动产生
比特流(.bit/.mcs)
最终下载文件
工具自动产生
你真正要负责的是前三类:设计、测试台、约束。其余都是工具跑出来的中间产物,可以删了重新生成。这也是为什么 FPGA 工程通常只把源码、testbench、约束提交版本管理,综合实现的产物目录(*.runs、*.cache)都加 .gitignore——它们体积大且可再生。
六、一次真实迭代的节奏
感受一下 FPGA 开发和写软件的节奏差别,一个典型小任务(比如让 LED 按 1 秒间隔闪烁)的循环是:
改 RTL:写计数器 + 比较逻辑(几分钟);写 testbench、跑行为仿真、看波形确认计数翻转对不对(几分钟,这步最关键);跑综合 + 实现(几分钟,期间可以喝口水);看时序报告确认无违例、看资源报告确认没超;生成比特流、JTAG 下载上板,看 LED 是否按预期闪;不对就回到第 1 步。
这个循环里,第 3~5 步是「等工具」的时间,改动越小、仿真越充分,循环次数越少。养成「先仿真到波形完全正确,再上板」的习惯,比任何高级技巧都能省时间。下一篇就用这个节奏,带你走完 第一个工程:LED 与计数器。
七、三种仿真:行为级、综合后、时序(门级)仿真
新手常以为「仿真」只有一种,其实随设计推进有三个层次,它们回答的问题不同:
仿真类型何时跑模型包含延迟主要回答
行为/功能仿真(前仿真)
写完 RTL
RTL 源码
不含门延迟(零延时或仅 #)
逻辑功能对不对
综合后仿真(可选)
综合后
映射后的原语网表
含估计延迟
综合有没有改变行为
时序/门级仿真(后仿真)
布局布线后
最终网表 + SDF 时序
含真实布线延迟
实际时序下是否还对
绝大多数日常开发只做**行为仿真 + 静态时序分析(STA)**这两件事:行为仿真保证功能对,STA 用数学方法穷举所有路径的时序,保证「在这个时钟下不存在来不及的路径」。门级仿真慢且维护成本高,只在处理硬核 IP、异步接口、第三方网表或怀疑 STA 有例外没约束到时才用。理解这个分工,你就明白为什么工程师不会「每次都跑到带延迟的仿真」,而是信任 STA 的结论。
八、看懂警告:哪些必须清零
工具每次跑完都会吐几十上百条 warning,新手要么全忽略、要么被吓到。按风险分三类对待:
一条实用纪律:每次综合实现后先把 Critical Warnings 和上面第一类清零,再看功能。很多「上板偶发错误」的种子,早在第一次综合的警告里就写明了,只是当时被略过。用 report_methodology、report_drc 这类命令能把潜在问题系统地列出来,比肉眼翻日志可靠。
九、省时间的工程习惯:增量、并行与最小复现
FPGA 编译慢是常态,大工程一次全编译几十分钟到几小时,工程习惯直接决定效率:
十、自测要点与学习地图
自测:① 不看材料复述从 RTL 到上板的七步,并说出每步的输入、产物和「错了回哪」;② 综合和实现的区别是什么,时序报告为什么在实现后才有意义;③ 写出寄存器路径周期预算不等式,解释 setup/hold 违例分别怎么修、为什么降频修不了 hold;④ 行为仿真能抓到什么、抓不到什么,为什么不能跳过仿真直接上板;⑤ 一个工程里哪些文件该提交 git、哪些是可再生产物;⑥ 看到 inferred latch、multi-driven、unconstrained clock 警告分别意味着什么。
学习地图:马上动手做 第一个工程 把流程走一遍;学写激励看 Testbench 与仿真;理解物理约束看 XDC 入门;建立电路范式看 组合与时序逻辑;进阶后系统学 STA 与 时序收敛方法。
十一、比特流加载与「为什么上板要等一下」
第七步下载看似简单,但理解配置时序能解释好几个现象。主流 SRAM FPGA 上电后并不会立刻执行你的逻辑,而是先运行内部的配置流程:清空配置存储 → 根据模式管脚确定配置源(JTAG 或 SPI Flash)→ 逐帧把比特流写入百万级配置单元 → 校验 → 释放全局复位和 I/O 三态、拉高 DONE。这通常耗时几十到几百毫秒,比特流越大越久。由此:
十二、把错误「对号入座」到流程的某一步
建立了完整流程后,遇到问题最有效的思路不是瞎试,而是先判断它属于哪一步、再回到那一步解决。下表把新手高频问题映射回流程:
现象最可能出问题的步骤先做什么
仿真波形就不对
RTL 设计 / testbench
回行为仿真,别上板
综合报 inferred latch、multi-driven
RTL 设计
改组合逻辑默认值/拆分多驱动
资源暴涨(LUT 几十万)
综合推断失败
查 RAM/DSP 是否正确推断、位宽、数组写法
布线失败/拥塞
实现(布局布线)
降占用、改大器件、加约束
Timing Summary 报红
时序分析
查 create_clock、插流水线、降频
下载成功但无反应
管脚/时钟/复位约束
按原理图核对 PACKAGE_PIN、时钟频率
仿真对上板偶发错
CDC/亚稳态、复位、接口
查跨时钟域同步、复位释放、真实接口时序
改代码但行为没变
没重跑综合/实现
确认 out-of-date 步骤已重新生成比特流
记住主线:逻辑问题在仿真阶段解决,资源/结构问题在综合阶段对 schematic,时序问题在实现后看报告,物理问题(管脚/时钟/复位)在上板时查约束。把现象对号入座,就不会在「明明仿真对了为什么不亮」上反复空转。
十三、两条正交的正确性:功能对,还要时序对
软件开发里「功能对了」基本就等于「正确」;FPGA 有两条互相独立、必须同时满足的正确性,这是初学者最需要建立的观念:
一个设计可以功能完全正确但时序不达标:仿真里每个时钟沿数据都理想地到位,但上板后某条长组合逻辑路径要 12ns 才稳定,而时钟周期只有 10ns,于是 FF 偶尔采到旧值/中间电平,表现为「时好时坏、温度高了更爱坏、换块板子现象不同」——这类问题最难调,因为它不是稳定的逻辑错误。反过来,时序 100% 收敛但功能写错(把加法写成减法),芯片会「又快又稳地给出错误答案」。
           功能对?           功能错?
时序过     正确,可发布       稳定地错(仿真就该抓到)
时序不过   偶发/温度相关故障    又错又危险
由此得到两条铁律:①仿真不过不上板(先保证功能);②时序不过不发布(再保证物理可达)。入门的慢时钟设计时序几乎天然满足,容易让人忽视第二条;一旦进入高速接口、DDR、PCIe、多时钟域,时序正确性会成为主要工作量,这也是进阶层 时序收敛 要系统解决的。
学会读资源利用报告:设计「有多大」
综合/实现后都会给一份 Utilization(资源利用)报告,新手只看「过没过」,老手会逐行看它,因为它同时反映规模和推断是否正确:
报告项含义异常时怀疑什么
LUT / LUTRAM
组合逻辑 / 被当分布式 RAM 用的 LUT
本该进 BRAM 的数组退化成 LUTRAM,LUT 暴涨
FF(寄存器)
触发器数量
意外推断锁存器、多余流水级、未复位大寄存器
BRAM(块 RAM)
硬存储器占用
该用没用(LUT 爆炸)或被意外拆成很多小块
DSP48
硬乘法/乘加器
乘法没用 DSP(用 LUT 搭,巨大),或位宽不对没被推断
IOB / BUFG / MMCM
IO 引脚 / 全局时钟缓冲 / 时钟管理器
时钟没走上全局网络、PLL 例化是否生效
读报告的方法是「横向比预期、纵向看趋势」:你心里对这个模块该用多少资源要有数量级概念(一个 LED 计数器几十个 FF,一个 FIFO 主要吃 BRAM,一个滤波器主要吃 DSP)。如果一个简单模块综合出几万 LUT,几乎一定是写法导致推断失败(数组没进 BRAM、乘法没进 DSP、状态机编码爆炸),而不是设计真的这么大。随着迭代记录资源趋势,某次提交后某类资源陡增,就能立刻定位到那次改动。这个习惯在 资源利用与优化 里会进一步展开。
最后提醒:综合/实现产物(*.runs、*.cache、网表、比特流)都是由「RTL + 约束 + IP 配置 + 器件型号」可重新生成的派生结果,体积大、不应进版本库;提交 git 的是源,不是产物。理解了「源 → 工具 → 产物」的单向生成关系,你就具备了和软件开发里「源码进库、二进制不进库」完全一致的工程素养,也能放心地随时清理中间目录、用脚本一键重建工程。
十四、版本管理与团队协作:工程文件该提交什么
一个 FPGA 工程目录里文件成百上千,哪些该进版本库、哪些该忽略,是从「自己练手」走向「能协作、能回溯」必须解决的问题。这一节给出可直接照做的划分原则。
先分清三类文件。第一类是人写的源文件:RTL(.v/.sv)、testbench、约束(.xdc/.sdc)、IP 的参数化配置或生成脚本、Tcl 构建脚本、仿真的 filelist/do 文件、README 和引脚对照表。这些是工程的「源代码」,必须纳入版本管理,而且应该是仓库的主体。第二类是工具生成的产物:综合/实现的 run 目录、网表、日志、比特流、JTAG 下载缓存、IP 生成出来的一大堆核文件。这些体积大、每次编译都变、且能由第一类文件重新生成,原则上不入库,用 .gitignore/svn:ignore 排除;需要保留可烧写的发布版本时,再把对应比特流单独归档到制品库并打上标签。第三类是与机器/用户相关的本地文件:IDE 记住的窗口布局、绝对路径、最近打开记录、本机 license 路径,这类文件既无协作价值又会在不同电脑上互相覆盖,通常也忽略。
为什么要这样切?核心原因是可复现性。一个干净的环境拉下仓库,只要工具大版本一致、执行构建脚本,就应当能生成功能相同的比特流——这要求入库的是「配方」而不是「菜肴」。如果把整个 run 目录提交,仓库会迅速膨胀到几个 GB,diff 全是二进制噪声,真正的源码改动反而被淹没;而如果漏提交了约束或 IP 配置,别人拉下代码根本编译不出来。判断某个文件该不该提交,有个简单测试:删掉它,能不能用已入库的文件重新生成? 能,就不提交;不能,就必须提交。
IP 核是这里最容易出问题的一环。厂商 IP 通常有两种管理方式:一种是只存 IP 的配置文件(如 Vivado 的 .xci 及其伴随的 xgui 参数),让别人编译时由工具自动(或由脚本显式)重新生成输出产物;另一种是连生成产物一起提交(称为「已生成 IP 入库」),好处是换机器不必重装/重生成,坏处是升级工具版本后产物可能失效。团队应统一选一种并写进 README,最忌有人提交产物、有人只提交配置,导致版本库里半新半旧。更稳妥的做法是用 Tcl 脚本记录 IP 的创建与参数(create_ip、set_property 一系列命令),这样 IP 本身也变成「可由脚本重建」的对象。
路径问题紧随其后。新手常把源文件放在 D:\mywork\project\... 这种绝对路径下,工程文件里记住的也是绝对路径,换台电脑或换个同事就大面积报红。正确做法是所有源文件都放在工程根目录之下、用相对路径引用,约束和 filelist 里也不写死盘符。配合构建脚本里「先定位脚本自身所在目录,再据此拼出工程根」的写法,可以做到整个仓库随意拷贝位置都能编译。
协作层面还有几条纪律值得尽早养成。一是一条改动只做一件事:修一个 bug 的提交里不要顺手大改风格,否则出了问题无法二分定位;二是提交信息写清「为什么」,尤其是时序例外、false path、特殊引脚约束这类「当时不得已」的改动,半年后回看能救命;三是约束和 RTL 同步提交,新增一个端口却忘了提交对应约束,是团队集成时最常见的红线来源;四是统一工具版本并写在 README 里,大版本混用会让「我机器上能过」成为永久争论。把这些纪律和前面章节的「增量编译、最小复现、回归仿真」结合起来,你就拥有了一套虽然轻量但足以支撑小团队的工程化流程——它和软件开发的版本管理思想一脉相承,区别只在于 FPGA 的「构建产物」更大、「工具版本」更敏感而已。
一句话总结
一句话总结:FPGA 开发是「Verilog 描述电路 → 行为仿真验功能 → 综合成 LUT/FF 网表 → 布局布线落到芯片 → 时序分析确认 setup/hold 收敛 → 生成比特流 → JTAG 下载」七步;功能错回 RTL、时序不过回代码或约束、上板异常回仿真,越早发现代价越小;和软件最大的不同是产物是并行电路、正确性要求功能与时序双达标、迭代慢,所以前仿真和「时序不过不上板」是两条铁律。
上一篇:FPGA 架构细致讲解