时间:2026-10-18 来源:FPGA_UCY 关于我们 0
FPGA开发实战:深度解析Xilinx Block RAM IP核的配置、仿真与调试
在FPGA项目开发中,片上存储资源的高效利用往往是决定系统性能和逻辑资源消耗的关键。Xilinx的Block RAM(BRAM)作为其FPGA架构中的核心存储单元,通过Vivado中的IP核形式提供了高度可配置的接口,但其丰富的参数选项和微妙的工作模式差异,常常让开发者,尤其是刚接触Xilinx工具链的工程师感到困惑。你是否曾遇到过仿真波形与预期不符,或者综合后时序报告出现令人费解的警告?这背后很可能就是对BRAM IP核行为模式的理解不够深入。
本文旨在超越简单的参数配置手册,从一个实际工程开发者的视角,带你深入Block RAM IP核的肌理。我们将不满足于“如何配置”,而是聚焦于“为何这样配置”以及“配置后如何验证”。通过结合具体的配置场景、详细的仿真案例,以及笔者在多个高速数据缓冲和图像处理项目中积累的调试经验,为你呈现一份从IP核定制到功能验证,再到常见问题定位的完整实战指南。无论你是需要实现一个简单的双端口FIFO,还是构建一个带复杂读写逻辑的帧缓冲区,对BRAM IP核的透彻理解都将使你事半功倍。
1. 理解核心:Block RAM IP核的架构与工作模式
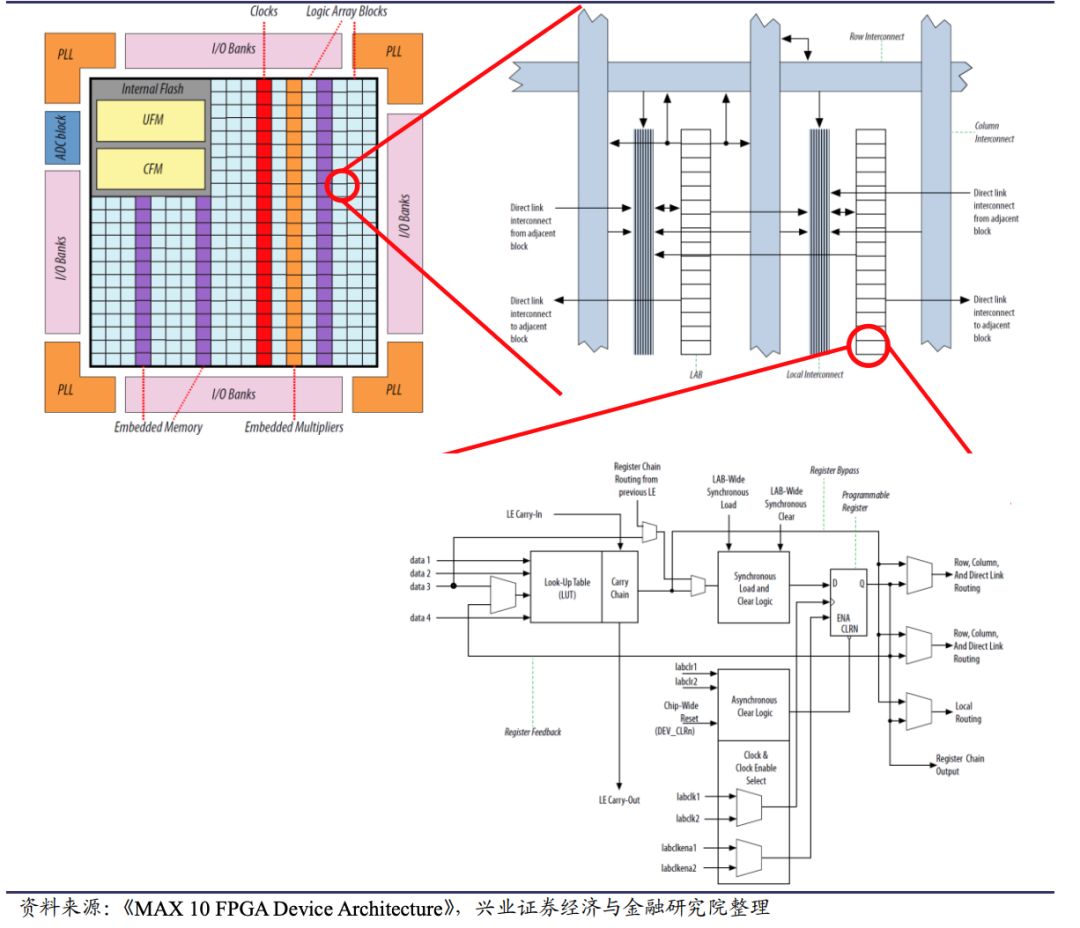
在开始点击Vivado IP Catalog中的“Block Memory Generator”之前,我们有必要先厘清几个基本概念。Xilinx FPGA中的Block RAM是物理上分布在整个芯片上的硬核存储单元,每个BRAM的容量是固定的(例如36Kb),但其组织方式(深度和宽度)可以通过IP核配置灵活改变。IP核的作用,就是将这些物理存储单元,包装成符合你特定需求(如端口数量、读写时序、使能信号)的存储器模块。
BRAM IP核支持三种最根本的写入模式,这直接决定了在写入操作发生时,输出端口(DOUT)的行为。理解这三种模式是避免后续仿真困惑的基石。
写入模式英文名称核心行为描述典型应用场景
写优先模式
Write First
写入的数据同时被存入存储单元并出现在输出总线上。输出总线在写操作期间“透明”地反映了输入数据。
需要实时反馈写入数据的场景,如某些先入先出(FIFO)的旁路逻辑,或调试时希望直接观察写入值。
读优先模式
Read First
在写入时钟沿,先将目标地址的旧数据读出到输出总线,然后再将新数据写入该地址。输出总线反映的是写操作发生前的数据。
最常见的模式。适用于需要保持输出数据连贯性的场景,例如在写入时不希望破坏当前输出流。
保持不变模式
No Change
在执行写操作期间,输出总线保持上一次读操作的数据不变,完全不受写入数据的影响。
用于严格分离读写数据路径的场景。写入操作完全不影响读端口的数据输出,简化了读端控制逻辑。
注意:这里的“优先”指的是在同一个时钟沿,对同一地址进行读写冲突时的仲裁行为。对于真正的双端口RAM,两个端口独立操作,不存在此优先级问题,除非两个端口同时写入同一地址(此时行为由硬件决定,通常应避免)。
除了写入模式,另一个至关重要的参数是读延迟。BRAM作为同步存储器,从地址输入到数据输出必然存在延迟。IP核允许你选择1、2或3个时钟周期的延迟。选择更大的延迟通常意味着BRAM内部可以配置成更高的运行频率(因为关键路径被寄存器打散了),但代价是增加了数据读出的等待时间。在数据流系统中,这个参数需要与流水线设计一并考虑。
// 一个简单的Verilog测试平台片段,用于理解读延迟
// 假设BRAM配置为读优先模式,读延迟=2
always @(posedge clk) begin
    if (enb) begin
        // 当前时钟沿:地址 addr 被锁存
        registered_addr <= addr;
        // 两个周期后,dout 将输出地址为 registered_addr 的数据
    end
end
// 因此,在仿真中,你会在地址变化的两个时钟周期后,才看到对应的数据出现在dout上。
2. 实战配置:在Vivado中定制你的Block RAM
打开Vivado的IP Integrator或直接使用IP Catalog,搜索并打开“Block Memory Generator”。界面看似复杂,但我们可以将其分解为几个逻辑步骤。
第一步:选择基础接口与存储器类型首先确定你需要的是单端口RAM、简单双端口RAM(一个端口只写,另一个端口只读)还是真双端口RAM(两个端口均可读写)。对于大多数缓存和缓冲区应用,简单双端口RAM是最常用的。真双端口RAM则用于需要高度并行访问的场景,但要注意避免地址冲突。
第二步:设置存储容量在“Port A Options”或“Memory Size”标签页,你需要指定“Write Width”和“Write Depth”。这里有个技巧:BRAM的物理容量是固定的(如36Kb)。Vivado会根据你设定的宽度和深度,自动计算并显示需要消耗的BRAM块数量。有时,稍微调整宽度或深度(例如,将宽度从36位改为32位,或深度从1024改为1023),可能会更高效地利用BRAM资源,减少块的使用数量。关注“Primality”和“Memory Size”旁边的提示信息很有帮助。
第三步:配置端口行为与时序这是最体现定制化的部分:
第四步:精细化控制与初始化
配置完成后,点击“OK”生成IP核。Vivado会生成一个封装好的.xci文件以及对应的Verilog/VHDL包装文件。建议花点时间阅读一下生成的示例实例化模板(Example Design),里面包含了端口声明和简单的连接示例。
3. 仿真验证:解读波形与验证功能
生成IP核只是第一步,用仿真验证其行为是否符合预期才是工程落地的关键。我们搭建一个针对简单双端口RAM(端口A写,端口B读)的测试平台。
测试场景设计:
初始写入:在时钟控制下,向端口A连续写入一组递增的测试数据。混合操作:在写入过程中,从端口B读取不同地址的数据,验证读优先模式下的行为。延迟验证:重点观察读延迟(假设配置为2)如何影响输出数据。
// 测试平台关键激励生成部分
initial begin
    // 初始化
    ena = 0; wea = 0; addra = 0; dina = 0;
    enb = 0; addrb = 0;
    #100; // 等待全局复位完成
    // 阶段1:连续写入数据 0xAA00 ~ 0xAA0F 到地址 0~15
    ena = 1;
    for (integer i = 0; i < 16; i = i+1) begin
        @(posedge clk);
        wea = 1;
        addra = i;
        dina = 16'hAA00 + i;
    end
    @(posedge clk);
    wea = 0; // 停止写入
    // 阶段2:从端口B读取地址 0, 2, 4...
    enb = 1;
    for (integer j = 0; j < 16; j = j+2) begin
        @(posedge clk);
        addrb = j;
        // 注意:由于读延迟=2,数据将在两个时钟周期后出现在doutb上
    end
    @(posedge clk);
    enb = 0;
    // 阶段3:同时读写测试(地址相同)
    @(posedge clk);
    ena = 1; enb = 1;
    addra = 8'h10; addrb = 8'h10; // 相同地址
    wea = 1;
    dina = 16'hDEAD; // 尝试写入新值
    // 观察doutb:在“读优先”模式下,应首先输出该地址旧值,下一个周期再输出新值(如果继续读)
    @(posedge clk);
    wea = 0;
    // ... 更多测试
    #1000 $finish;
end
在仿真波形中(如Vivado Simulator或ModelSim),你需要重点关注以下几点:
提示:在Vivado仿真器中,你可以将BRAM IP核内部的某些信号(如mem数组)添加到波形窗口中。虽然这通常不是必须的,但在深度调试某些“诡异”问题时,直接观察存储器的内容变化能提供最直接的证据。
4. 高级应用与性能优化
掌握了基本配置和仿真后,我们可以探讨一些更深入的应用技巧和性能考量。
实现异步FIFO的核心:简单双端口BRAM是构建异步FIFO(先入先出队列)的理想底层存储器。一个端口由写时钟域控制,负责顺序写入;另一个端口由读时钟域控制,负责顺序读出。关键在于,你需要用格雷码(Gray Code)来实现跨时钟域的写指针和读指针同步,以避免亚稳态。BRAM本身提供的是同步存储器,真正的“异步”特性是由外部的指针管理逻辑实现的。
资源优化策略:
时序收敛技巧:BRAM通常位于FPGA芯片的固定位置,其输入输出路径的延迟可能成为设计的关键路径。除了之前提到的启用“可选输出寄存器”,还有以下方法:
5. 调试与常见问题排查
即使仿真通过了,在硬件上仍可能遇到问题。以下是一些典型问题及排查思路。
问题一:仿真波形正确,但上板后读出的数据不对。
问题二:时序报告显示BRAM路径建立/保持时间违例。
问题三:在同时读写相同地址时,观察到非预期的数据输出。
调试FPGA设计,尤其是存储相关逻辑,需要耐心和系统的方法。从仿真到硬件的每一步,都保持信号的可观测性(充分利用仿真和ILA),并严格对照数据手册,是快速定位问题的关键。Block RAM IP核作为经过充分验证的硬核,其本身出错的概率极低,绝大多数问题都源于我们对其复杂接口和模式的理解偏差或配置疏忽。通过本文的梳理,希望你能建立起一套从配置、仿真到调试的完整方法论,从而在未来的项目中更加自信地驾驭这一强大的存储资源。